Comment télécharger et gérer des documents sur la plateforme Coolset ?
Last updated: October 20, 2026
Sur la plateforme Coolset, vous pouvez utiliser notre bibliothèque de données. Il s'agit d'un hub centralisé où les utilisateurs peuvent télécharger, organiser et gérer les documents clés utilisés dans plusieurs enquêtes et modules de conformité.
Dans la Bibliothèque de données, vous pouvez :
Créer et gérer des documents
Télécharger des fichiers dans différents formats (par ex. XBRL, .csv, PDF)
Ajouter du contexte à chaque document avec un nom, une description et un propriétaire
Modifier ou supprimer des documents selon vos besoins
Les documents peuvent être téléchargés en masse
Accéder à un hub de documents centralisé
Afficher tous les documents téléchargés dans une interface unique avec fonction de recherche
Trouver rapidement des documents par nom
Les documents peuvent être stockés dans des dossiers
Suivre l’utilisation des documents
Voir quelles questions de vos enquêtes font référence à chaque document
Cliquez pour accéder directement aux questions pertinentes
Utiliser vos documents pour le préremplissage automatique de la plateforme
Lorsqu’un document est prêt à être utilisé avec la fonctionnalité de préremplissage automatique par IA, la mention « Ajouté aux connaissances » s’affiche dans la colonne des connaissances de l’IA
📄 Comment utiliser Smart Autofills pour accélérer vos rapports ESG (version bêta)
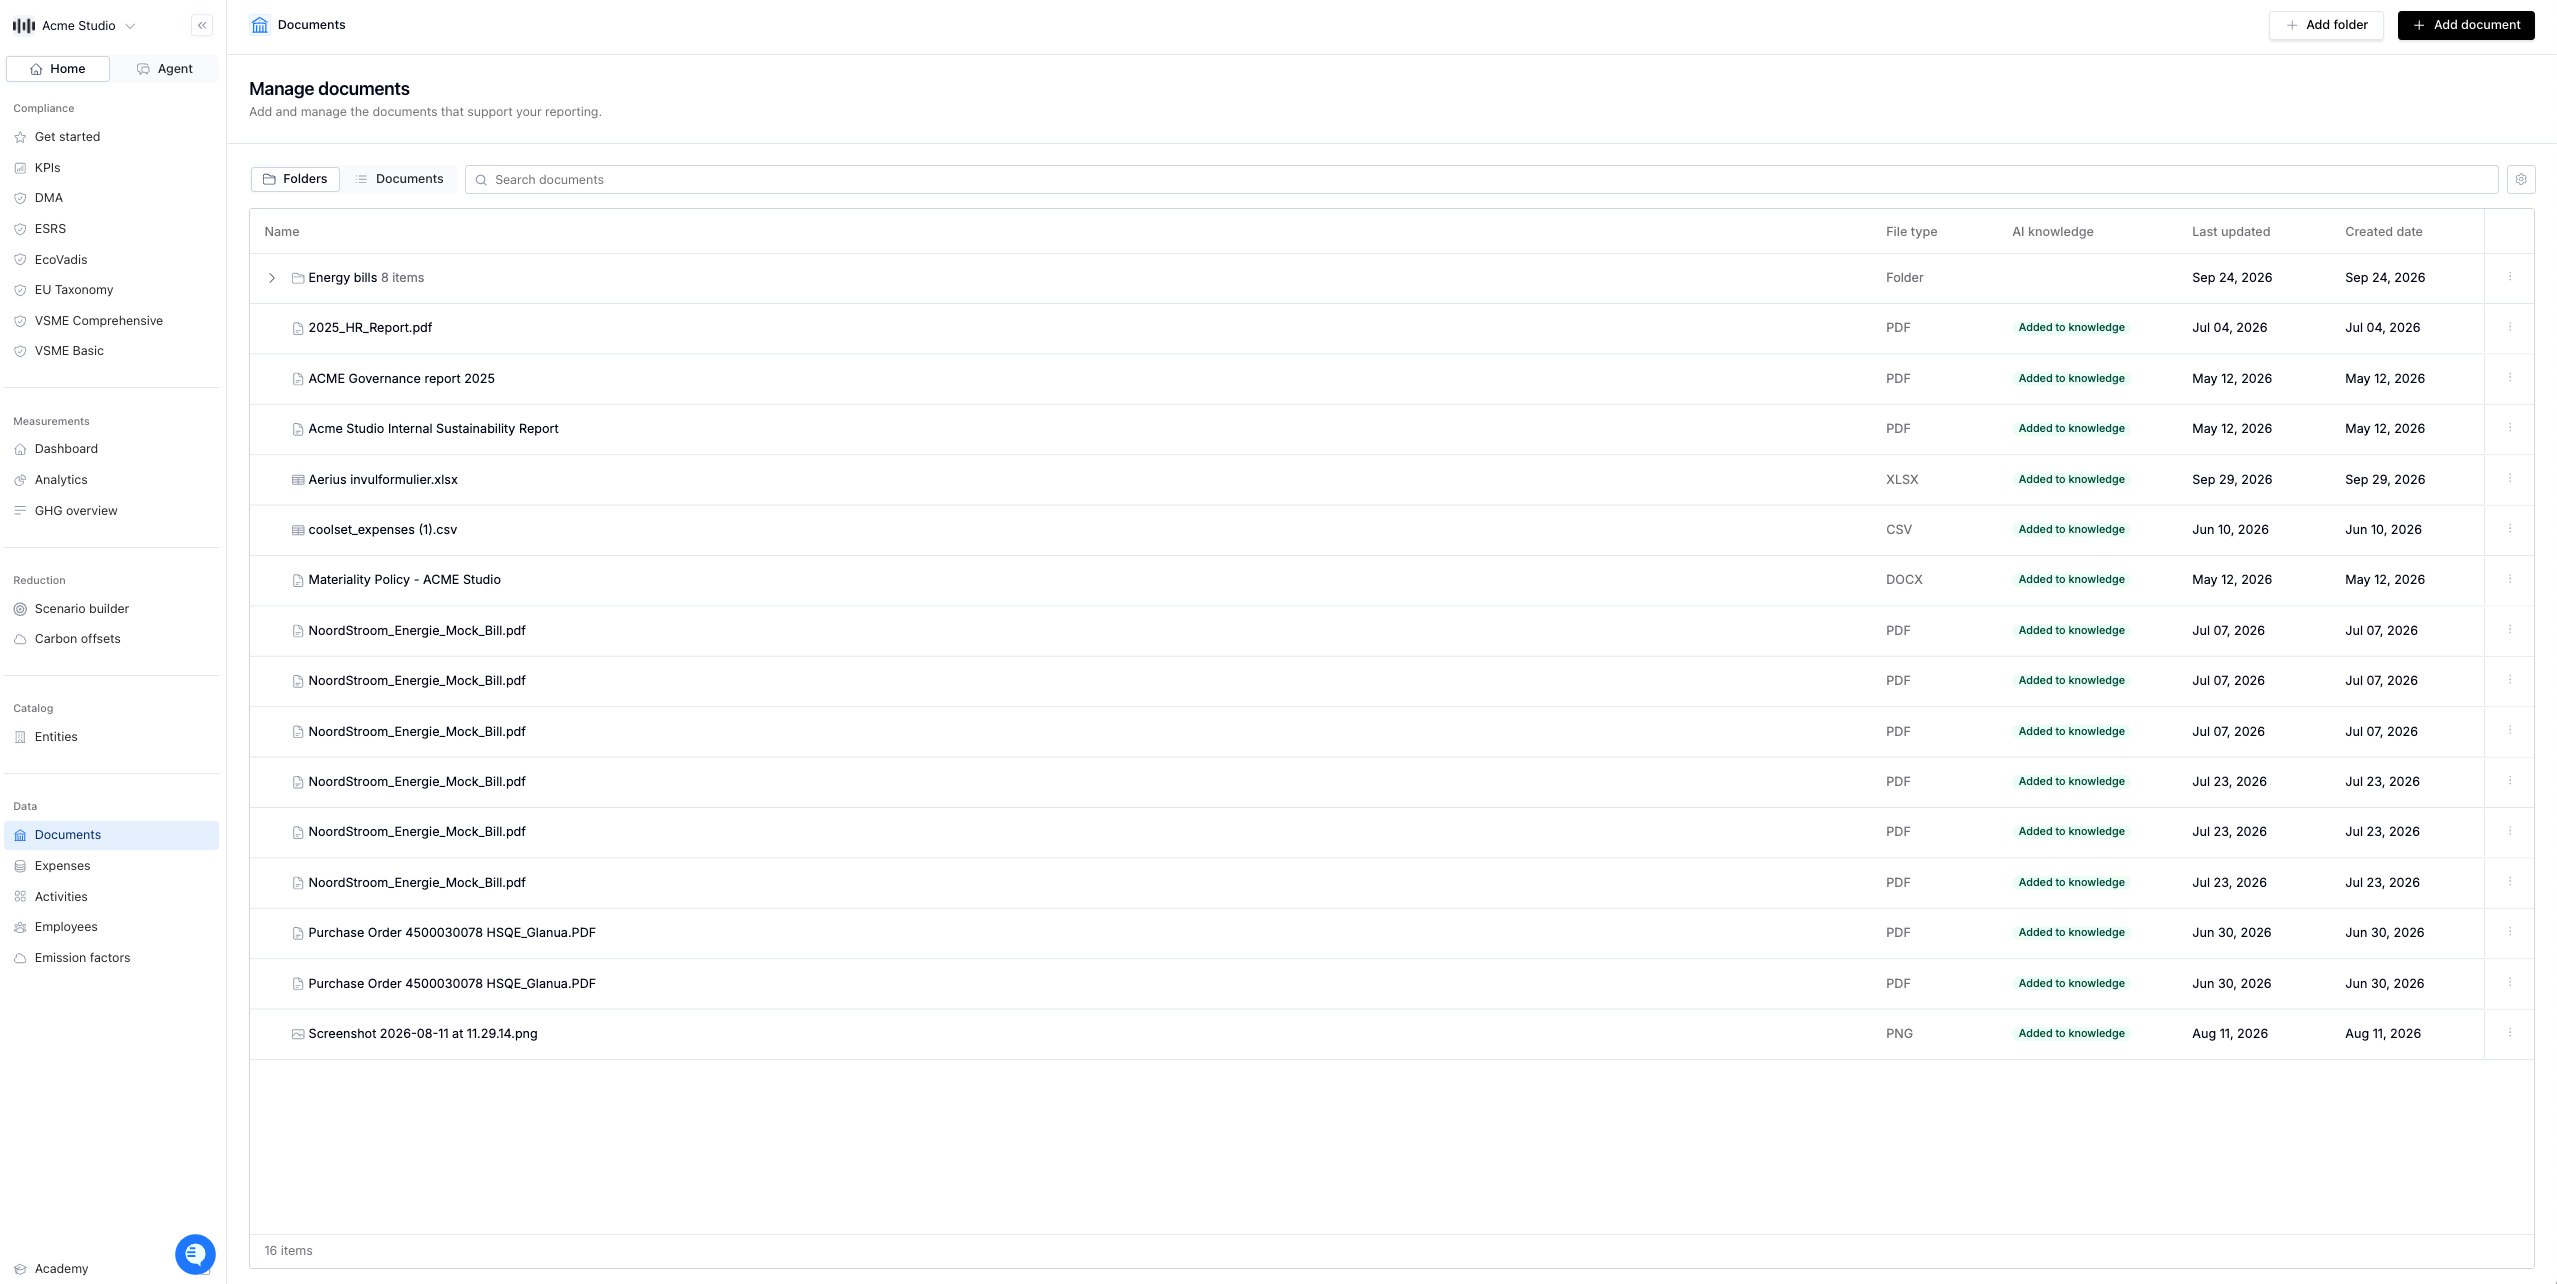
Vous trouverez la bibliothèque de données dans la navigation principale de votre espace de travail Coolset. Commencez par télécharger un fichier et lui attribuer un nom et un propriétaire. À partir de là, vos documents seront accessibles à tous les modules de conformité activés.
FAQ :
Pourquoi mon document n’affiche-t-il pas encore « Ajouté aux connaissances » ? Après avoir importé un document, Coolset le traite avant que les outils d’IA puissent l’utiliser. Pendant ce traitement, la colonne des connaissances de l’IA affiche « Ajout aux connaissances ». Cela prend généralement quelques minutes. Actualisez la page si le statut ne change pas. Certains types de fichiers sont stockés dans la Bibliothèque de données, mais ne sont pas indexés pour l’IA. Ils apparaissent comme non pris en charge.